イントロ
キーワードリサーチは過去2年間で、それ以前の20年間よりも大きく変化した。
検索エンジンはもはやキーワードマッチングだけに依存していない。大規模言語モデル(LLM)が理解するエンティティ、埋め込み表現、意味ベクトル、トピッククラスターに依存している。同時に、LLM自体が以下を実現する強力なツールとなった:
✔ トピッククラスターの生成
✔ 意味的関係の特定
✔ エンティティのマッピング
✔ 不足しているサブトピックの発見
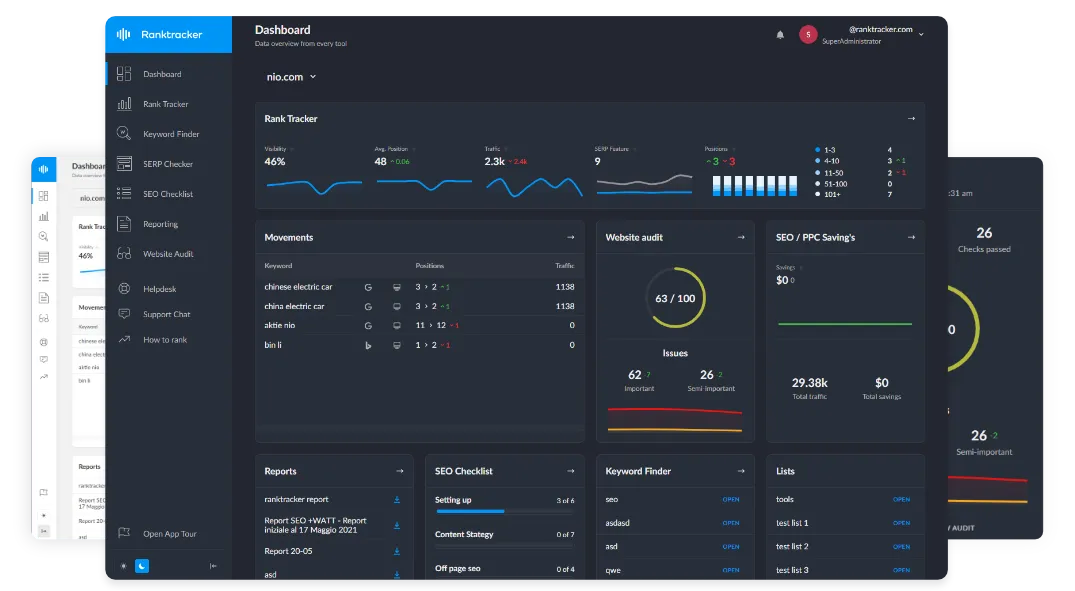
効果的なSEOのためのオールインワン・プラットフォーム
ビジネスが成功する背景には、強力なSEOキャンペーンがあります。しかし、数え切れないほどの最適化ツールやテクニックがあるため、どこから手をつければいいのかわからないこともあります。でも、もう心配はありません。効果的なSEOのためのオールインワンプラットフォーム「Ranktracker」を紹介します。
✔ ユーザー意図の分析
✔ AI概要トリガーの予測
✔ コンテンツ分類体系の構築
✔ トピックの権威性構築
本記事では、従来のキーワード調査を上回るキーワードクラスターとエンティティマップを構築するために、LLMを正しく安全に活用する方法を解説します。同時に、Ranktrackerのデータ駆動型ツールを統合し、インサイトの検証と運用化を実現します。
1. キーワードリサーチがキーワードからエンティティへ移行した理由
従来のSEOは次のように機能していました:
キーワード → コンテンツ → 順位
効果的なSEOのためのオールインワン・プラットフォーム
ビジネスが成功する背景には、強力なSEOキャンペーンがあります。しかし、数え切れないほどの最適化ツールやテクニックがあるため、どこから手をつければいいのかわからないこともあります。でも、もう心配はありません。効果的なSEOのためのオールインワンプラットフォーム「Ranktracker」を紹介します。
現代のAI駆動型検索はこう機能します:
エンティティ → 関係性 → 意図パターン → ベクトルクラスター → 回答
大規模言語モデル(LLM)は世界を次のように理解する:
✔ エンティティ
✔ 属性
✔ 関係性
✔ 階層構造
✔ コンテキスト
✔ ベクトル空間における近接性
コンテンツ戦略をキーワードのみに依存すると、以下の問題が生じます:
✘ トピックにおける権威性を失う
✘ 重要なサブトピックを見逃す
✘ AIサマリーに表示されない
✘ 生成型回答での表示が困難になる
✘ 一貫性のない情報でLLMを混乱させる
エンティティ駆動型クラスタリングは、現代のSEOとLLM最適化の基盤となっている。
2. LLMがトピックを理解する方法:ベクトル、埋め込み、意味的近接性
LLMはキーワードを学習しません。 関係性を学習します。
ChatGPT、Gemini、Claudeにトピックを尋ねると、モデルは以下の手法を用いる:
ベクトル埋め込み
意味の数学的表現。
意味的近傍
関連する概念のグループ。
コンテキストウィンドウ
概念の局所的なクラスター。
エンティティグラフ
誰/何が誰/何に関連するか。
これは、LLMが自然に優れていることを意味します:
✔ キーワードクラスターの作成
✔ 関連する意図のグループ化
✔ 関係性のマッピング
✔ トピックの空白を埋める
✔ ユーザーの質問予測
✔ 大規模な検索行動のモデリング
正しくプロンプトを設定するだけで十分です(Ranktrackerで検証してください)。
3. LLMが構築できる3種類のキーワードクラスター
LLMが特に得意とする生成:
1. 意図ベースのクラスター
ユーザーの求める内容でグループ化:
-
情報提供型
-
情報提供型
-
トランザクショナル
-
ナビゲーション
-
比較
-
トラブルシューティング
2. 意味的トピッククラスター
意味と近接性でグループ化:
-
「AI SEOツール」
-
「LLM最適化」
-
「構造化データとスキーマ」
3. エンティティ中心クラスター
以下の要素を中心にグループ化:
-
ブランド
-
人物
-
製品
-
カテゴリ
-
属性
-
特徴
Ranktrackerの例:
✔ Ranktracker → 機能 → 順位追跡 → キーワード調査 → 監査 → バックリンク → SERP分析
✔ 競合他社 → エンティティ隣接性 → 比較クラスター
✔ ユースケース → エンタープライズSEO → ローカルSEO → eコマースSEO
LLMはこの点で優れており、内部のナレッジグラフがエンティティファースト構造だからです。
4. LLMを活用したキーワードクラスター構築方法(ステップバイステップ)
AI主導のトップSEOチームが現在採用している正確なワークフローをご紹介します。
ステップ1 — Ranktrackerキーワードファインダーでシードトピックを生成
実際の検索データから開始:
✔ シードキーワード
✔ ロングテールクエリ
✔ 質問形式の用語
✔ AI意図クエリ
✔ 商業的修飾語
キーワードファインダーは、事実に基づく検索需要から始めることを保証し、妄想的な用語ではありません。
ステップ2 — それらのキーワードをLLMに投入し、意味的グループ化を行う
プロンプト例:
「これらのキーワードを意味的クラスターにグループ化し、各クラスターに親トピック、サブトピック、ユーザー意図、提案記事タイトルを付与。構造化された階層形式で出力せよ」
LLMが生成する内容:
✔ 親テーマ
✔ 補足サブトピック
✔ 見逃されている機会
✔ 質問ベースの拡張
これは最初のパスです。
ステップ3 — LLMにエンティティマップへの展開を依頼
プロンプト例:
「これらのクラスターに関連する全てのエンティティ(ブランド、概念、人物、特徴、属性を含む)を特定してください。それらの関係性を示し、主要、二次的、三次的に分類してください。」
出力結果はエンティティマップとなり、以下に不可欠です:
✔ LLM最適化(LLMO)
✔ AIO
✔ AEO
✔ コンテンツクラスタリング
✔ 内部リンク
✔ トピック権威性
ステップ4 — トピックギャップリストを生成する
プロンプト:
「このクラスターには、ユーザーが期待しているにもかかわらず、ブランドがまだカバーしていないトピック、質問、またはエンティティは何か?」
LLMが特に得意とする識別項目:
✔ 不足しているFAQ
✔ 不足しているユースケース
✔ 不足している比較ページ
✔ 不足している定義
✔ 隣接する意図の欠落
これにより、AI可視性を損なうコンテンツの空白を防止します。
ステップ5 — Ranktrackerで検索ボリュームと難易度を検証
LLMが構造を提供します。 Ranktrackerが正当性を提供します。
検証項目:
✔ 検索ボリューム
✔ キーワード難易度
✔ SERP競争状況
✔ 意図の正確性
✔ クリック可能性
✔ AI概要の妥当性
このステップでは、幻覚や低価値の拡張をフィルタリングします。
ステップ6 — 公開可能なトピックマップへの整理
最終的なトピックマップには以下を含める必要があります:
✔ 柱となるページ
✔ サブトピック
✔ ロングテール意図ページ
✔ エンティティアンカーページ
✔ 比較ページ
✔ FAQクラスター
✔ 用語集クラスター
✔ AI最適化サマリー
LLMが全体像を構築する手助けをし、Ranktrackerがそれを数値化する。
5. LLMを活用したエンティティマップ構築法(完全版)
エンティティマップは現代の検索可視性の基盤です。
LLMは4種類のエンティティマップを生成可能:
1. 主要エンティティ
意味の主要な対象。
例: _Ranktracker _ _Google Search Console _ _SERPトラッキング _キーワードリサーチ
2. 補助エンティティ
二次的な関連エンティティ。
例: _検索可視性 _ _順位変動性 _キーワードカニバリゼーション
3. 属性エンティティ
特徴や特性。
例: _順位追跡間隔 _ _SERP深度 _ _上位100件の結果 _キーワードリスト
4. 近接エンティティ
意味的に近接した概念。
例: _LLM最適化 _ _AIO _ _構造化データ _エンティティSEO
LLMはこれら4種類すべてを正確に出力できる。
6. LLMエンティティマッピングプロンプト(永遠に使い続けるべきもの)
以下がマスタープロンプトです:
「トピック:[トピック名] の完全なエンティティマップを作成してください。
以下を含めること: – 主なエンティティ – 二次的なエンティティ – 属性 – アクション – 問題点 – 解決策 – ツール – 指標 – 関連専門用語 – 人物 – ブランド – 競合エンティティ – 意味的に類似した項目 階層的なグラフとして提示すること。」
これにより、数分で世界クラスのエンティティマップが生成されます。
次に以下のツールでエンティティを検証:
✔ Ranktracker SERP Checker(実世界の関連性を確認)
✔ バックリンクチェッカー(ドメインレベルでのエンティティ隣接性を把握するため)
7. LLMクラスター + Ranktrackerデータ = 新しいキーワードリサーチの公式
現代的なワークフローは以下の通りです:
1. Ranktracker = 検索現実
ボリューム KD SERP競争状況 検索意図 CPC AI概要トリガー
2. LLM = 意味構造
意味 関係性 エンティティ クラスター トピック階層 ギャップ
3. 人間 = 戦略と優先順位付け
編集判断 ビジネス関連性 ブランドポジショニング リソース配分
この三角関係こそが、SEOと生成型可視性の未来である。
8. 高度な技術:クラスター優先順位付けにおけるLLMの活用
LLMは以下に基づいてクラスターの優先順位付けが可能:
✔ 意図の成熟度
✔ ファネル段階
✔ 収益への影響
✔ 権威の活用
✔ 競合飽和度
✔ AI概要の機会
✔ エンティティ権威の整合性
プロンプト:
「収益性、ランキングの容易さ、LLM可視化可能性の観点から、これらのクラスターをランク付けしてください。」
これにより、従来のSEO計画を上回るロードマップが生成されます。
9. 最も重要なルール:LLMに実際のキーワードデータを置き換えてはならない
LLMは強力だが、検索行動を幻覚する。
絶対に信用してはいけないもの:
✘ AI生成の検索ボリューム
✘ AI生成のキーワード難易度
✘ 作り出された修飾語
✘ 偽の商業クエリ
常にRanktracker Keyword Finderで検証すること。
LLMが構造化。 Ranktrackerが検証。
10. RanktrackerがLLM支援型キーワードクラスタリングをどうサポートするか
キーワードファインダー
LLMクラスタリング用の実データシードを提供。
SERPチェッカー
エンティティ関係と競合状況を検証します。
ランクトラッカー
大規模なクラスタのパフォーマンスを表示します。
Web Audit
ページがLLM向けに機械可読であることを保証します。
AI記事ライター
構造化され、クラスターに整合し、エンティティの一貫性を保ったコンテンツを生成します。
バックリンクチェッカー+モニター
外部コンセンサスを通じてエンティティ関連性を強化。
LLMがマップを構築します。 Ranktrackerがマップ制覇を支援します。
最終的な考察:
LLMはキーワードリサーチを置き換えるためではなく、再構築するために存在する
LLMは私たちに前例のない力を与える:
✔ 意味のマッピング
✔ エンティティを理解する
✔ トピックのクラスタリング
✔ 不足箇所の特定
✔ 検索意図の予測
✔ 生成型回答のモデル化
効果的なSEOのためのオールインワン・プラットフォーム
ビジネスが成功する背景には、強力なSEOキャンペーンがあります。しかし、数え切れないほどの最適化ツールやテクニックがあるため、どこから手をつければいいのかわからないこともあります。でも、もう心配はありません。効果的なSEOのためのオールインワンプラットフォーム「Ranktracker」を紹介します。
しかし未来を掴むのは、これらを組み合わせたブランドだ:
AI理解力 + 実データ + 人的戦略。
LLMが構造を構築する。 Ranktrackerがデータを検証する。 あなたがビジネス目標に結びつける。
これがLLM主導の検索環境でトピックの権威を構築する新たな青写真だ。